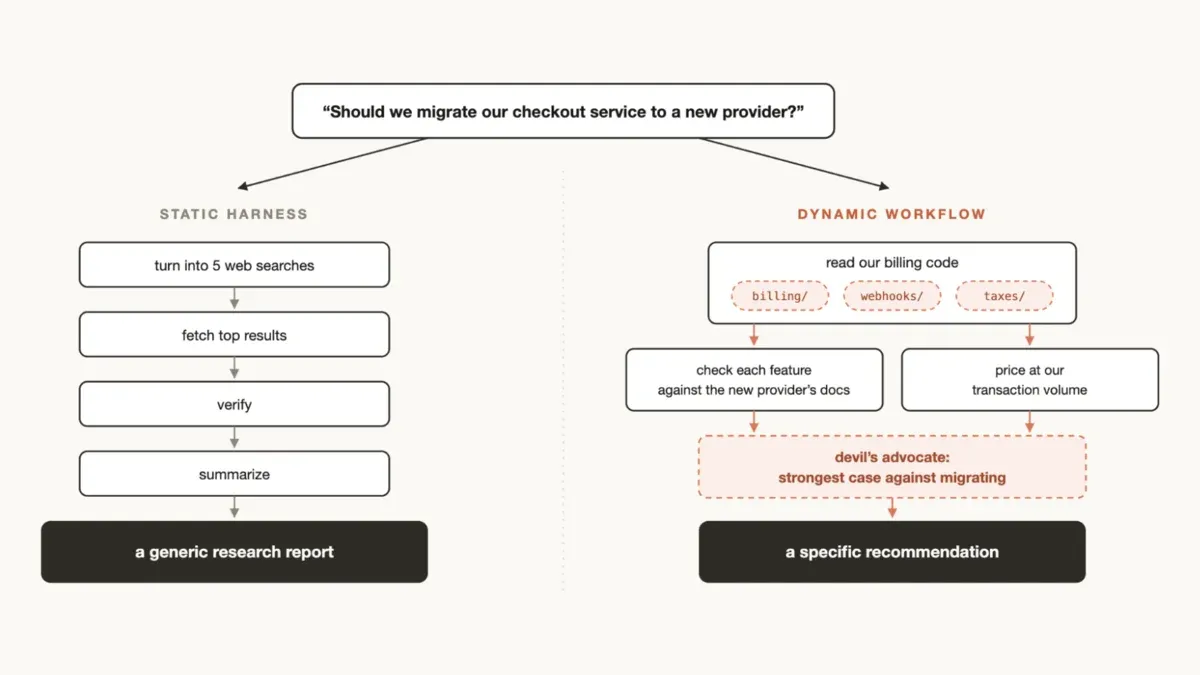
一個 AI 助理從早上陪你做到下午,早上交代的「正式資料不要動」,到了傍晚它可能已經忘了。任務越長、越雜,一個 AI 越容易漏東漏西。多代理協作框架就是為這種狀況設計的。
多代理協作框架(multi-agent harness)是什麼? Harness 指模型外面那一整套裝備:讓它反覆行動的迴圈、能呼叫的工具、context(模型當下看得到的全部內容)的管理,還有護欄。有了這套裝備,模型才成為 agent,能自己決定下一步、自己用工具把事情做完。多代理協作框架是它的多人版:一個指揮者(orchestrator)把大工作拆給好幾個 agent,每個 agent 用自己獨立的 context 做一小塊,只交回精簡的結果。指揮者可以是一個 AI,也可以是一段寫好的程式。
這篇用白話整理 Anthropic、OpenAI、Google、Microsoft 官方文件裡反覆出現的做法,再加上小企鵝的 AI 團隊實際跑一次的實戰紀錄。
一個 AI 為什麼不夠?
Anthropic 替單一 agent 做長任務時的毛病取了三個名字:
- Agentic laziness(做到一半說做完):Anthropic 舉的例子是一份 50 項的資安檢查,只處理了 35 項就宣布完成。
- Self-preferential bias(自己改自己的考卷):叫它檢查自己的成果,它會偏向自己。
- Goal drift(聊久了忘了原本要什麼):對話變長、舊內容被壓成摘要,每壓一次都可能漏掉細節,「不要做 X」這類限制就可能這樣掉了。
另外還有 context 汙染:前一個子任務留下的資料,一直干擾下一個。解法是把工作拆給幾個各有乾淨 context、只盯一個目標的 agent。負責檢查的 agent 如果只拿到結果和標準、看不到做事那方的推理,也比較不會幫它圓場,這一點需要刻意安排。
計畫拿在誰手上?
Claude Code 的文件用一句話區分各種做法:「差別在於誰拿著計畫。」計畫可以在指揮的 AI 手上,由它每一輪決定下一步,彈性大,但所有結果都回到它的 context,做久了越塞越滿。計畫也可以寫成程式,由腳本保管步驟和中間結果,指揮的 AI 只需要看最終答案。前者像主管邊做邊想,後者像照一張寫好的流程表走。不管哪一種,重點都是讓指揮者的 context 保持乾淨。
六種常見組法
Anthropic 整理了六種組法,實務上會混著用:
- Classify-and-act(先分類,再派工):先判斷任務類型,再交給對應的 agent。像是分流客服信。
- Fan-out-and-synthesize(拆開平行做,再彙整):切成小塊同時做,全部完成才彙整。像是多方向的調查。
- Adversarial verification(對抗式驗證):另派 agent 拿標準挑毛病。用在出錯代價高的產出。
- Generate-and-filter(大量發想,再篩選):產生很多點子,用標準或實際驗證篩選、去除重複,只留最好的。像是發想標題。
- Tournament(淘汰賽):各做一版,兩兩比較選出最好的。Anthropic 認為兩兩比較比打絕對分數可靠。
- Loop until done(直到沒有新發現為止):持續派 agent 去找,直到停止條件成立,例如 log 裡不再出現新錯誤。
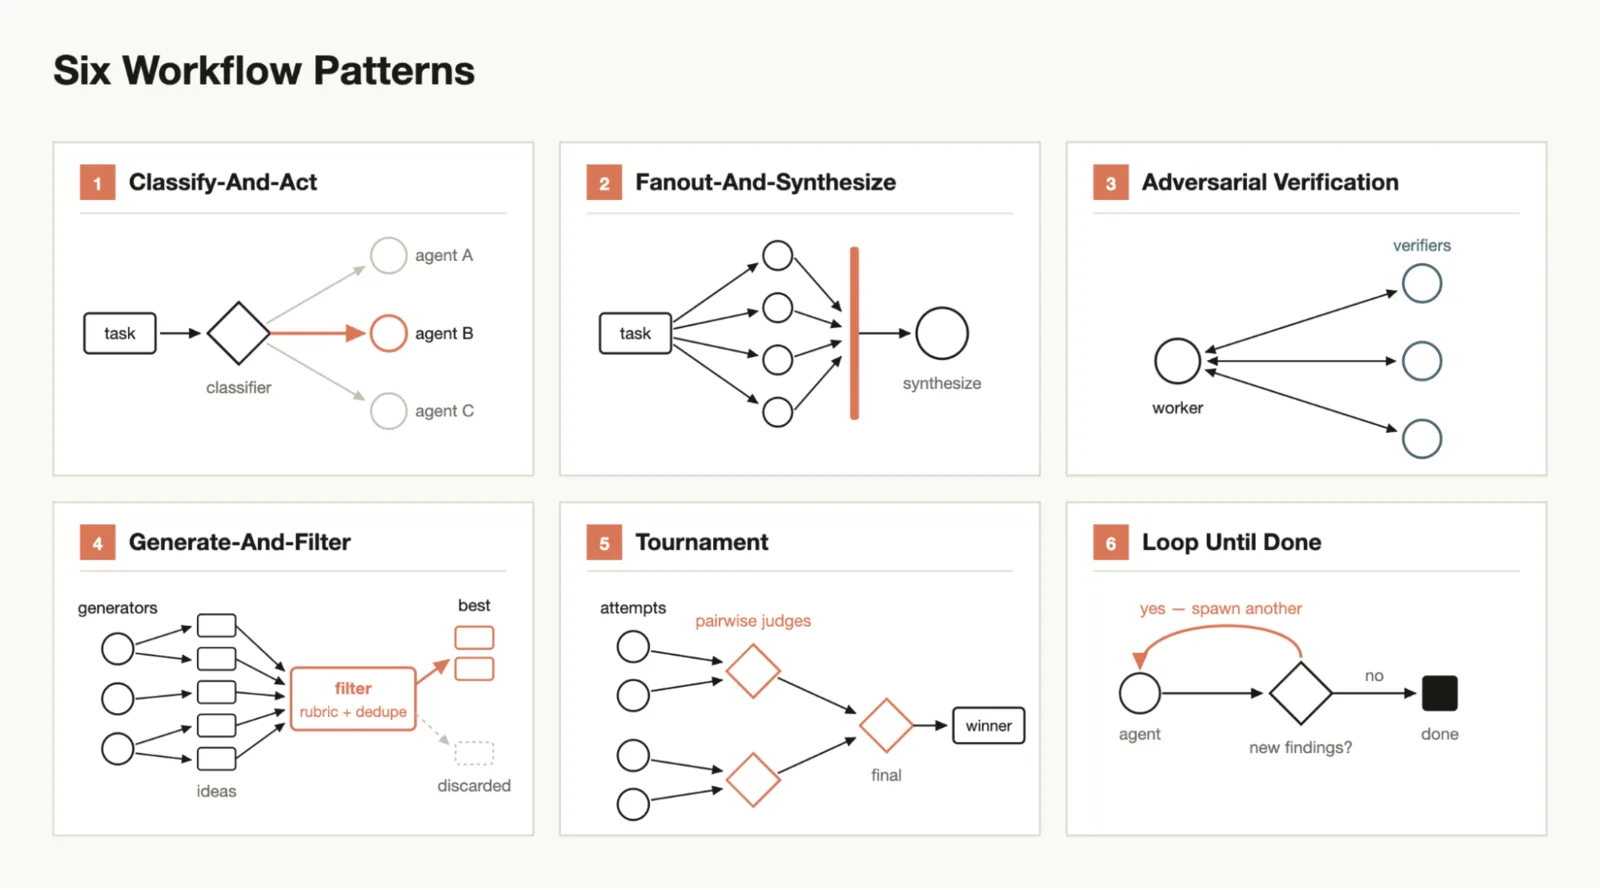
圖一:六種組法。圖片來源:Anthropic(claude.dev)
Agent 會讀網頁、信件、留言這類外來內容時,還有一種組法叫隔離區(quarantine):負責讀取的 agent 不做高權限動作,真正動手的 agent 只看它們交出的摘要,不碰原文。這類風險可以看 AI Agent 的安全風險。
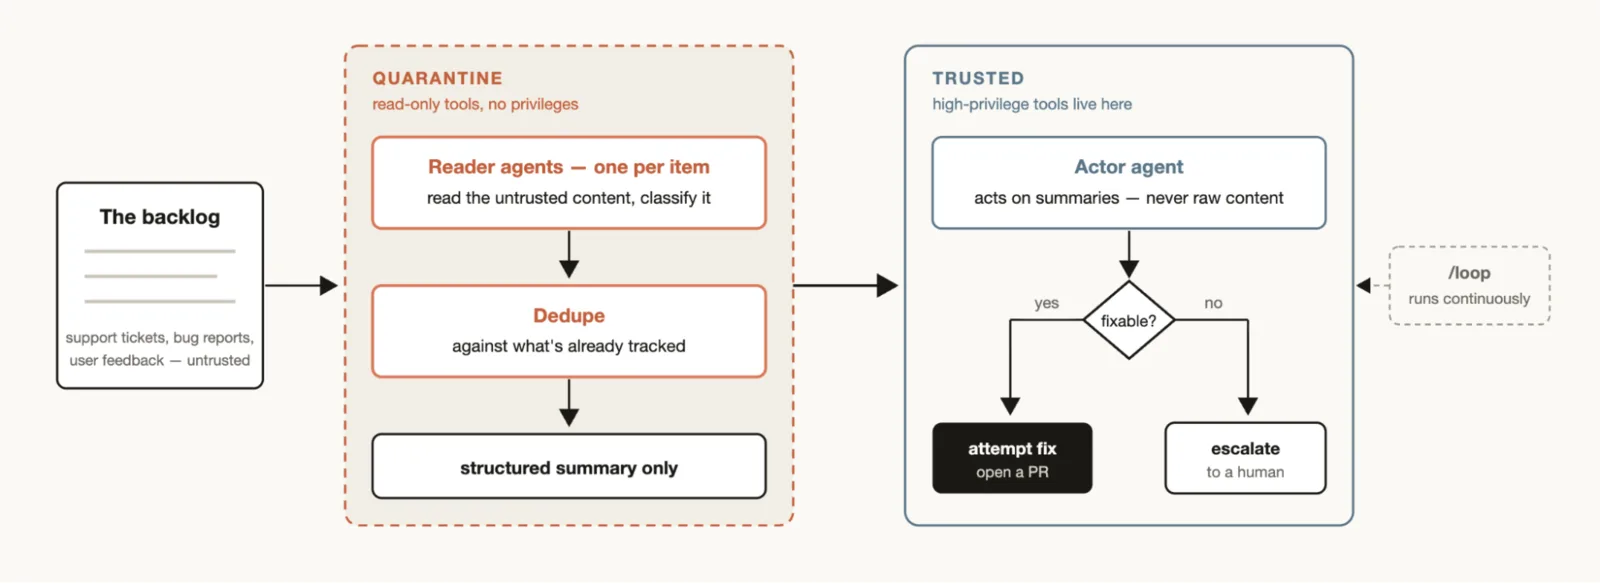
圖二:讀取外來內容的 agent 待在隔離區,有權限的 agent 只看摘要。圖片來源:Anthropic(claude.dev)
實戰:一篇文章,九個 AI
2026 年 9 月,小企鵝的 AI 團隊用這套方法寫了一篇新產品解析。分工是:一個指揮的 AI(訂計畫、寫簡報、決定收或退,自己不寫文章)、六個調查 agent(一人一題、各交一個證據檔,其中一個專門核對別人的說法;同一時間最多跑三個,其餘排隊)、一個只能用證據檔的寫稿 agent,還有一個另一家模型的審稿 agent。中途有幾個位置換過替補:一家模型的調查額度用完,經小企鵝同意,剩下的調查改由另一家模型的 agent 接手;審稿也換過人,下面會講。小企鵝本人負責文章角度、封面和按下發布。
從「開始」到拿到指揮者對照證據檢查過的稿子,大約一個半小時;最後的審稿又多花了一個多小時,原因在下表最後一列。
| 出了什麼錯 | 誰抓到 | 學到什麼 |
|---|---|---|
| 簡報的前提錯了:把產品名當成一個模型系列,其實同名的也是一個給一般使用者的 agent App | 調查 agent 回報,指揮者親自抽查一手資料確認 | 簡報送出前,先驗證最關鍵的前提 |
| 指揮者自己說錯:看完官方頁面,就說「應該沒有候補名單」 | 社群調查 agent 找到使用者回報在 App 裡看到候補畫面;小企鵝本人一開始就是對的 | 官方頁面沒寫,不代表不存在 |
| 寫稿 agent 把媒體報導的「人類撥出電話」寫成「人類接聽電話」 | 指揮者拿證據檔逐段對稿,連同其他問題共退回 12 處 | 讀稿要對照原始證據 |
| 指揮者對過稿之後仍留下的錯:常見問答和開頭跟修正後的內文矛盾、只有一家媒體報導的細節被寫成兩家 | 另一家模型的審稿 agent 直接讀證據,抓出 8 個必須修的問題;指揮者也拿審稿者沒看過的影片畫面,駁回其中一條 | 最後一關放不同家;審稿意見也要拿證據檢驗 |
| 審稿 agent 額度用完,替補的兩次只交回進度訊息、沒有結論 | 指揮者直接打開產出檢查,沒有只看「執行完畢」 | 「跑完了」不等於「做完了」 |
前提寫錯,agent 只會照著錯的前提認真做完。表上五個問題,有兩個跟指揮者自己有關。這幾層各自抓到不同的錯,沒有哪一層可以單獨信任,指揮者自己也一樣。
什麼時候不該用?
OpenAI、Microsoft、Anthropic 的文件都建議先把單一 agent 做好,簡單的方法能解決就別加 agent。多 agent 適合寬而平行、互不依賴的工作,例如多方向的調查、把一條條說法拆開核對;同一份檔案要多人改、每一步都依賴上一步的工作,交給一個 agent 比較好。
一個簡單的判斷法:這件工作能不能拆給幾個人各查各的、互不干擾?能,才值得找一群 AI;不能,就先把一個 AI 的簡報寫好。
成本也會成倍增加:每個 agent 各自消耗 token(模型處理文字、計算費用的單位),交接和協調還要再算一份。研究也提醒要保守:Cemri 等人 2025 年的論文分析 7 個開源多 agent 系統,失敗率在 41% 到 86.7% 之間。
五條設計原則
- 照資訊的邊界切工作。 先想哪些資訊要放在一起,再分工。Anthropic 做過實驗,照職稱分工(規劃、實作、測試、審查)的 agent,花在協調上的 token 比實際做事還多。比較好的切法是互不相干的調查方向,或只看結果的獨立檢查。
- 簡報寫清楚。 Subagent 看不到你跟指揮者聊過什麼。目標、輸出格式、該用的來源、任務邊界都要寫,路怎麼走交給執行的人。Anthropic 也發現,規劃時把技術細節寫太細、又寫錯,錯誤會一路傳到下游。
- 做事的和檢查的分開。 檢查要有具體標準,也要防反方向的問題:叫審查 agent 找缺點,就算作品沒問題,它通常也會找出一些。Anthropic 的做法是一條規則配一個檢查者,再由一個「懷疑派」agent 過濾誤報。
- 用檔案交接。 成果寫成檔案,只回傳很短的參照(檔案在哪),避免一路轉述、一路失真。同一份東西,同一時間只讓一個 agent 改。
- 設停止條件,人守關鍵關卡。 重試和迭代要有上限,碰到上限怎麼辦也要先想好,Microsoft 舉的例子是轉給人處理。敏感、不可逆的動作,留給人確認。
審稿要不要換一家模型?
小企鵝的團隊讓另一家模型把守最後一關。研究確實發現,模型替答案打分時會偏好自己的產出;也有研究發現,越強的模型犯錯越相似,就算來自不同廠商也一樣。我們讀過的 Anthropic、OpenAI、Google、Microsoft 官方文件,都沒有要求換一家來審,Anthropic 要的是新的模型實例,加上乾淨的 context。所以小企鵝把換一家當成便宜的保險,實際抓到的例子就是上面表格第四列。撐起品質的,是審稿者有乾淨的 context、直接讀原始證據、手上有具體的檢查標準。
小企鵝的總結
- 寫簡報像交接給新同事。 對方沒聽過你們之前聊了什麼。最關鍵的前提,送出前先自己驗一次。
- 檢查的跟做事的分開。 不會寫程式也能套用:開兩個對話,一個寫,一個只拿原始資料逐條挑錯。小企鵝團隊實際的做法是寫稿只准用證據檔,最後一關換另一家模型審。
- 一個 AI 做得好,就別叫一群。 多 agent 留給範圍大、能平行、做錯很貴的工作。
- 品味、授權、不可逆的決定留給人。 文章角度、封面、按下發布,在小企鵝的團隊裡都還是小企鵝自己來。
Anthropic 的工程團隊寫過:harness 裡的每個零件,都藏著一個「模型自己做不到什麼」的假設。模型變強以後哪些零件可以拆掉,小企鵝的團隊還在一個一個試。
更多基礎觀念可以從 AI Agent 專區 開始看;context 怎麼運作,可以看 AI Agent 的記憶機制。
參考資料
封面圖片來源:Anthropic(claude.dev)
官方文件會持續更新,內容以 2026-09-23 讀取為準。
- Anthropic(claude.dev):A harness for every task: dynamic workflows in Claude Code,https://claude.dev/blog/a-harness-for-every-task-dynamic-workflows-in-claude-code/
- Anthropic:Building multi-agent systems: when and how to use them,https://claude.com/blog/building-multi-agent-systems-when-and-how-to-use-them
- Anthropic:Harnessing Claude’s intelligence,https://claude.com/blog/harnessing-claudes-intelligence
- Claude Code 文件:Workflows,https://code.claude.com/docs/en/workflows
- Claude Code 文件:Glossary,https://code.claude.com/docs/en/glossary
- Claude Code 文件:Subagents,https://code.claude.com/docs/en/sub-agents
- Claude Code 文件:Agent teams,https://code.claude.com/docs/en/agent-teams
- Claude Code 文件:Best practices,https://code.claude.com/docs/en/best-practices
- Anthropic Engineering:Building effective agents,https://www.anthropic.com/engineering/building-effective-agents
- Anthropic Engineering:How we built our multi-agent research system,https://www.anthropic.com/engineering/multi-agent-research-system
- Anthropic Engineering:Harness design for long-running application development,https://www.anthropic.com/engineering/harness-design-long-running-apps
- OpenAI:A practical guide to building agents,https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
- Google Agent Development Kit:Workflows,https://google.github.io/adk-docs/workflows/
- Microsoft Azure Architecture Center:AI agent orchestration patterns,https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/ai-agent-design-patterns
- Microsoft Agent Framework:Overview,https://learn.microsoft.com/en-us/agent-framework/overview/
- Cognition:Multi-Agents: What’s Actually Working(2026),https://cognition.com/blog/multi-agents-working
- Cemri et al.(2025)Why Do Multi-Agent LLM Systems Fail?,https://arxiv.org/abs/2503.13657
- Kim et al.(2025)Towards a Science of Scaling Agent Systems,https://arxiv.org/abs/2512.08296
- Wang et al.(2024)Rethinking the Bounds of LLM Reasoning: Are Multi-Agent Discussions the Key?,https://arxiv.org/abs/2402.18272
- Panickssery et al.(2024)LLM Evaluators Recognize and Favor Their Own Generations,https://arxiv.org/abs/2404.13076
- Wataoka et al.(2024)Self-Preference Bias in LLM-as-a-Judge,https://arxiv.org/abs/2410.21819
- Verga et al.(2024)Replacing Judges with Juries,https://arxiv.org/abs/2404.18796
- Kim et al.(2025)Correlated Errors in Large Language Models,https://arxiv.org/abs/2506.07962