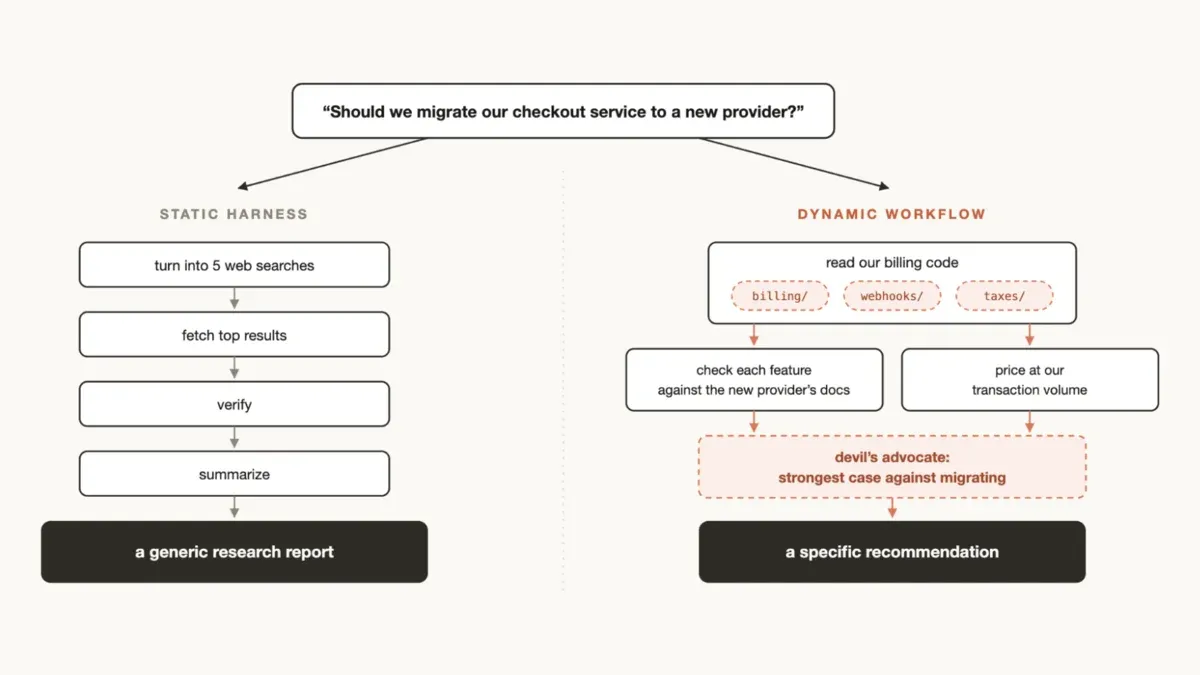
朝から夕方まで1人のAIアシスタントに付き合ってもらうと、朝に伝えた「正式な資料は変更しないで」という指示を、夕方には忘れているかもしれません。仕事が長く複雑になるほど、1つのAIは抜け漏れを起こしやすくなります。マルチエージェント協調フレームワークは、こうした状況のために設計されています。
マルチエージェント協調フレームワーク(multi-agent harness)とは何でしょうか? Harnessとは、モデルの外側にある一式の仕組みです。モデルを繰り返し動かすループ、呼び出せるツール、context(モデルがその時点で見られるすべての情報)の管理、そしてガードレールが含まれます。この一式があって初めて、モデルはエージェントになり、次の一手を自分で決め、ツールを使って仕事を完了できるようになります。マルチエージェント協調フレームワークは、その複数人版です。1人の指揮役(orchestrator)が大きな仕事を複数のエージェントに分け、それぞれが独立したcontextで一部を担当し、簡潔な結果だけを返します。指揮役はAIの場合も、あらかじめ書かれたプログラムの場合もあります。
この記事では、Anthropic、OpenAI、Google、Microsoftの公式資料に繰り返し登場する方法をやさしく整理し、さらに小企鵝のAIチームが実際にこの方法を1回試した記録も紹介します。
なぜ1つのAIでは足りないのか?
Anthropicは、単一エージェントに長い仕事をさせたときの問題に、3つの名前を付けています。
- Agentic laziness(途中で完了したと言う):Anthropicの例では、50項目のセキュリティチェックのうち35項目しか処理していないのに、完了したと宣言しました。
- Self-preferential bias(自分の答案を自分で採点する):自分の成果をチェックさせると、自分の成果をひいきします。
- Goal drift(会話が長くなって最初の目的を忘れる):会話が長くなると、古い内容が要約に置き換えられます。そのたびに細部が抜ける可能性があり、「Xをしないで」のような制約もそこで失われます。
ほかにも、contextの汚染があります。前のサブタスクが残した情報が、次の仕事にいつまでも影響する問題です。対策は、仕事をいくつかのエージェントに分け、それぞれにクリーンなcontextと1つの目標だけを与えることです。チェック担当のエージェントに結果と基準だけを渡し、実行側の推論を見せなければ、実行側の間違いをかばうことも減ります。この分離は意識して設計する必要があります。
計画を持つのは誰か?
Claude Codeの資料は、さまざまな方法を「計画を持つのは誰か」という一言で区別しています。計画を指揮役のAIが持ち、各ラウンドで次の一手を決める方法は柔軟ですが、すべての結果がそのAIのcontextに戻るため、長く続けるほど詰め込まれていきます。計画をプログラムとして書き、スクリプトが手順と途中結果を管理する方法もあります。この場合、指揮役のAIは最終回答だけを見れば済みます。前者は上司が考えながら仕事を進めるようなもので、後者は書かれた手順表に沿って進めるようなものです。どちらでも、重要なのは指揮役のcontextをクリーンに保つことです。
よくある6つの組み方
Anthropicは6つの組み方を整理しています。実際には、これらを組み合わせて使います。
- Classify-and-act(分類してから実行):まず仕事の種類を判断し、対応するエージェントに任せます。問い合わせメールの振り分けがその例です。
- Fan-out-and-synthesize(分けて並行処理し、統合):小さな単位に分けて同時に処理し、すべて終わってから統合します。複数の方向から調べる調査がその例です。
- Adversarial verification(対抗的な検証):別のエージェントに基準を渡して問題点を探させます。失敗のコストが高い成果物に使います。
- Generate-and-filter(大量に発想してから絞り込む):多くのアイデアを出し、基準や実際の検証で選別し、重複を除いて最良のものだけを残します。タイトル案の作成がその例です。
- Tournament(トーナメント):それぞれが1案を作り、2つずつ比較して最良のものを選びます。Anthropicは、絶対評価の点数を付けるより、2つを比べるほうが信頼できるとしています。
- Loop until done(新しい発見がなくなるまで繰り返す):停止条件が成立するまで、エージェントを継続的に調査へ送り出します。たとえばログに新しいエラーが出なくなるまで続けます。
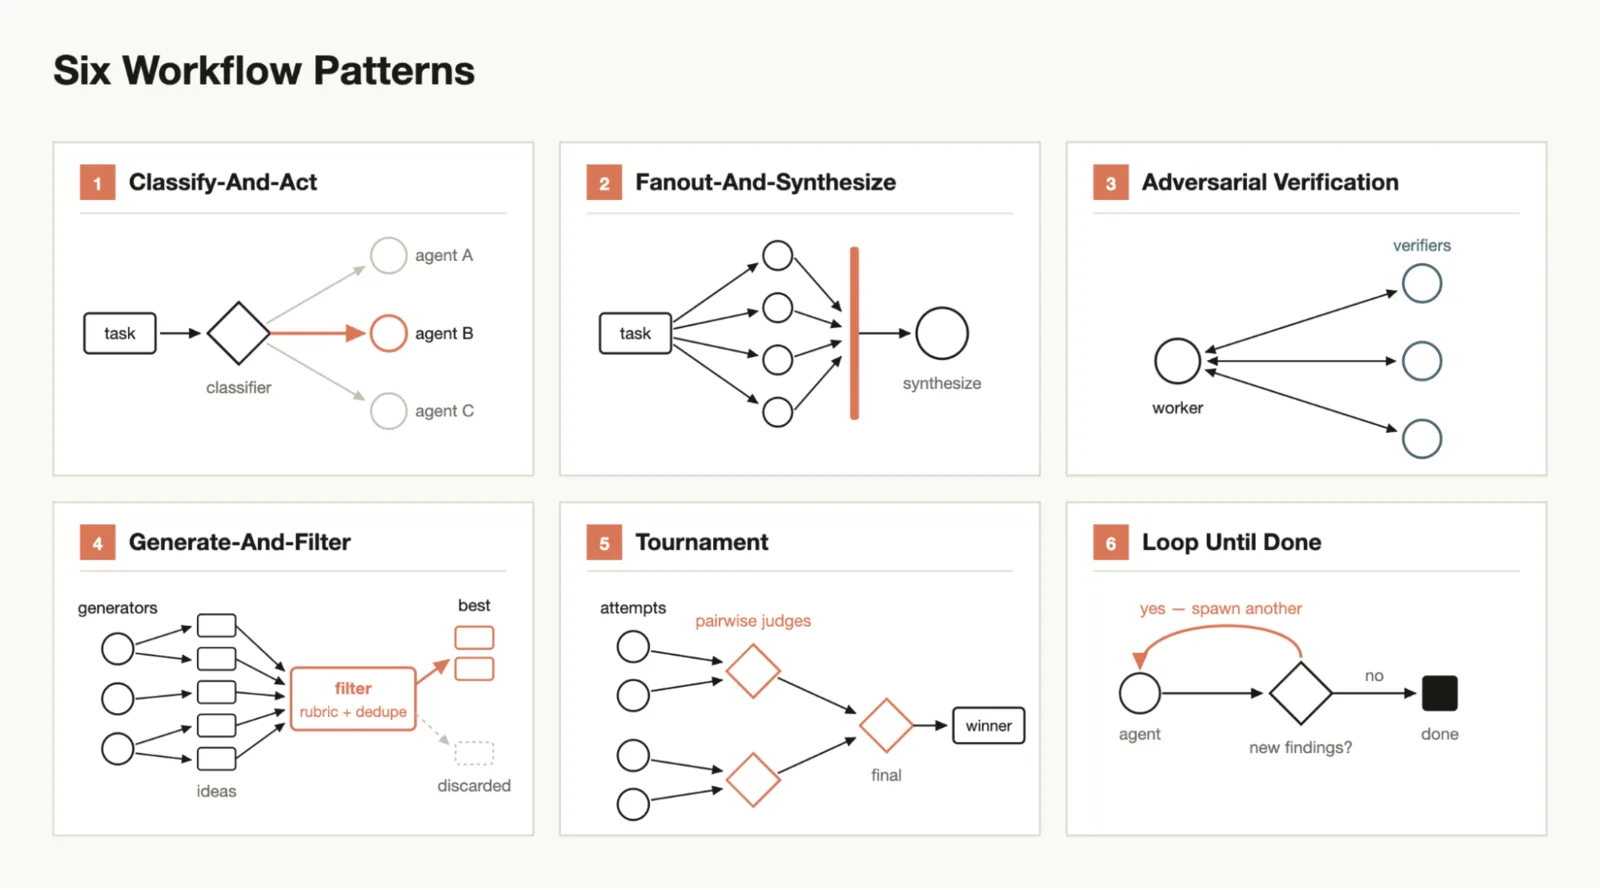
図1:6つの組み方。画像出典:Anthropic(claude.dev)
エージェントがウェブページ、メール、コメントのような外部コンテンツを読む場合は、**隔離区(quarantine)**という組み方もあります。読み取り担当のエージェントには高い権限の操作をさせず、実際に操作するエージェントは、読み取り担当が返した要約だけを見て、原文には触れません。この種のリスクについては、AIエージェントのセキュリティリスクも参照してください。
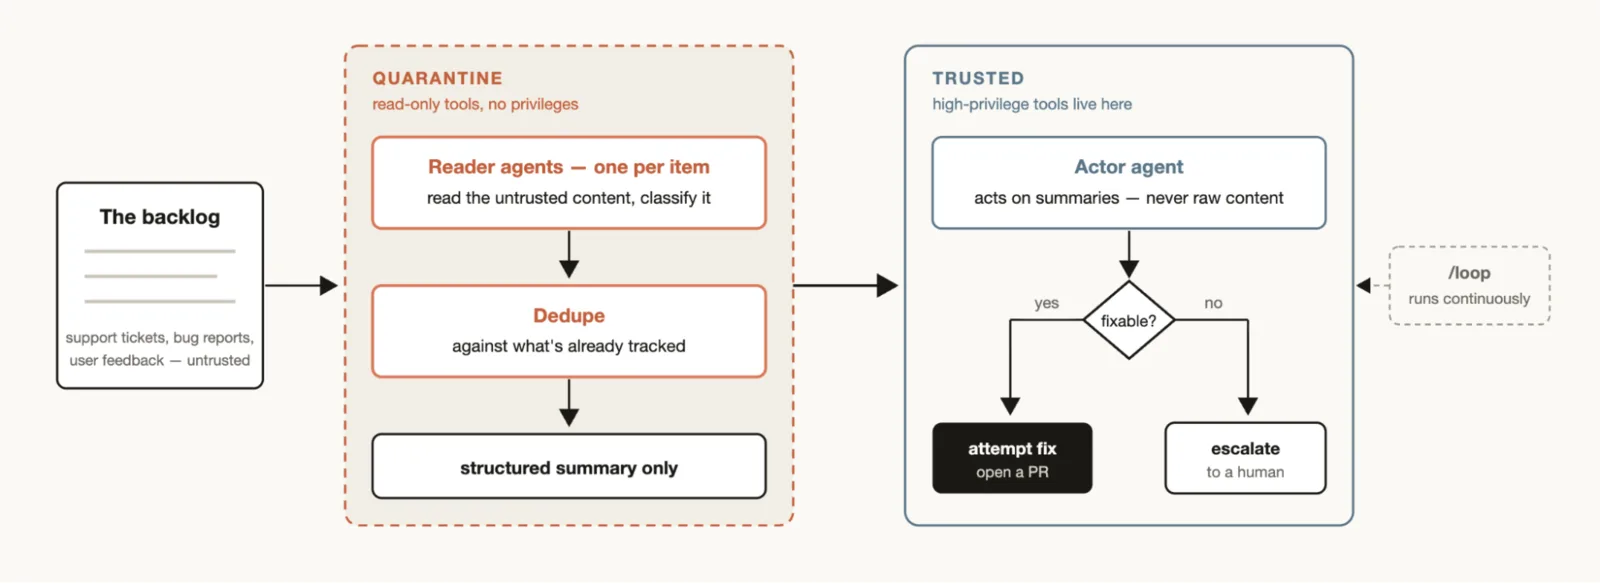
図2:外部コンテンツを読むエージェントは隔離区に置き、権限を持つエージェントは要約だけを見る。画像出典:Anthropic(claude.dev)
実践:1本の記事に9個のAI
2026年9月、小企鵝のAIチームはこの方法で新製品の解説記事を書きました。分担は次のとおりです。指揮役のAIが1つ(計画を立て、作業指示を書き、採用か差し戻しかを決める。自分では記事を書かない)、調査エージェントが6つ(1人1テーマ、それぞれが1つの証拠ファイルを納品し、そのうち1つは他の主張の照合を専門に担当。同時に動かすのは最大3つで、残りは順番待ち)、証拠ファイルだけを使う執筆エージェントが1つ、そして別の会社のモデルによるレビュアーが1つです。途中で、いくつかの役割を代替要員に替えました。あるモデルの調査枠を使い切ったため、小企鵝の同意を得て、残りの調査を別の会社のモデルのエージェントに引き継ぎました。レビュー担当も交代しましたが、その話は後で説明します。小企鵝本人は、記事の切り口、カバー画像、公開ボタンを担当しました。
「開始」から、指揮役が証拠と照合してチェックした原稿を受け取るまで、およそ1時間半かかりました。最後のレビューにはさらに1時間余りかかりました。その理由は、次の表の最後の行にあります。
| 起きた間違い | 誰が見つけたか | 学んだこと |
|---|---|---|
| 作業指示の前提が間違っていた:製品名をモデルシリーズだと扱ったが、同じ名前のものは一般ユーザー向けのエージェントアプリでもあった | 調査エージェントが報告し、指揮役が一次資料を自分で抜き打ち確認した | 作業指示を渡す前に、最も重要な前提を検証する |
| 指揮役自身が間違えた:公式ページを読んだ後、「順番待ちリストはないはずだ」と言った | コミュニティ調査エージェントが、アプリ内で順番待ち画面を見たというユーザー報告を見つけた。小企鵝本人の最初の判断は正しかった | 公式ページに書かれていないからといって、存在しないとは限らない |
| 執筆エージェントが、メディア報道の「人間が電話をかけた」を「人間が電話に出た」と書いた | 指揮役が証拠ファイルと原稿を段落ごとに照合し、ほかの問題と合わせて12か所を差し戻した | 原稿は元の証拠と照合して読む |
| 指揮役がチェックした後も残った間違い:FAQと冒頭が修正後の本文と矛盾していた。また、1社だけが報じた詳細を2社が報じたように書いていた | 別の会社のモデルのレビュアーが証拠を直接読み、必ず直すべき8つの問題を見つけた。指揮役はレビュアーが見ていない動画の画面も確認し、そのうち1つを退けた | 最後の関門には別の会社のモデルを置き、レビュー意見も証拠で検証する |
| レビュアーが利用枠を使い切り、代替担当は2回とも進捗メッセージだけを返し、結論を出さなかった | 指揮役が「実行完了」という表示だけを信じず、成果物を直接開いて確認した | 「実行が終わった」ことは「仕事が終わった」ことではない |
前提が間違っていれば、エージェントは間違った前提に沿って、まじめに仕事を完了してしまいます。表の5つの問題のうち、2つは指揮役自身に関係していました。これらの層はそれぞれ別の間違いを見つけましたが、どの層も単独では信頼できません。指揮役自身も同じです。
使わないほうがよいのはどんなとき?
OpenAI、Microsoft、Anthropicの資料はいずれも、まず単一エージェントをうまく使い、簡単な方法で解決できるならエージェントを増やさないよう勧めています。マルチエージェントに向くのは、範囲が広く、並行して進められ、互いに依存しない仕事です。たとえば複数の方向から調べる調査や、主張を1つずつ分けて検証する作業です。同じファイルを複数人で編集する仕事や、各段階が前の段階に依存する仕事は、1つのエージェントに任せたほうがよいでしょう。
簡単な判断方法があります。この仕事は、何人かに分けて、それぞれが互いに邪魔せず調べられるでしょうか? できるなら、AIのチームに分ける価値があります。できないなら、まず1つのAIへの作業指示を整えましょう。
コストも倍々に増えます。エージェントごとにtoken(モデルが文章を処理し、料金を計算するときの単位)を消費し、引き継ぎと調整にも別のコストがかかるからです。研究も慎重な姿勢を促しています。Cemriらの2025年の論文は、7つのオープンソースのマルチエージェントシステムを分析し、失敗率が41%から86.7%の範囲にあると報告しました。
5つの設計原則
- 情報の境界に沿って仕事を分ける。 まず、どの情報を一緒に扱う必要があるかを考えてから分担します。Anthropicの実験では、計画、実装、テスト、レビューという職種に沿ってエージェントを分けると、実際の作業より調整に多くのtokenを使いました。互いに関係のない調査の方向や、結果だけを見る独立したチェックに分けるほうがよい方法です。
- 作業指示を明確に書く。 Subagentには、あなたが指揮役と話した内容が見えません。目的、出力形式、使うべき資料、仕事の範囲を明記し、進め方は実行担当に任せます。Anthropicは、計画段階で技術的な細部を書きすぎ、しかも間違えると、その誤りが下流まで伝わることも見つけています。
- 実行担当とチェック担当を分ける。 チェックには具体的な基準を設け、逆方向の問題にも備えます。レビュアーに欠点を探させると、作品に問題がなくても、たいてい何かを見つけてしまいます。Anthropicは、1つのルールに1人のチェック担当を割り当て、さらに「疑い深い」エージェントに誤検知をふるい落とさせています。
- ファイルで引き継ぐ。 成果をファイルに書き、返すのは「ファイルがどこにあるか」という短い参照だけにします。そうすれば、何度も言い換えるうちに内容が変わるのを防げます。同じものを同時に編集するエージェントは1つだけにします。
- 停止条件を決め、重要な関門は人間が守る。 再試行と反復には上限を設け、上限に達したときの対応も先に決めます。Microsoftの例では、人間に引き継ぎます。敏感な操作や取り消せない操作は、人間が確認するようにします。
レビューでは別の会社のモデルに替えるべき?
小企鵝のチームは、最後の関門を別の会社のモデルに任せました。研究では、モデルが回答を採点するとき、自分の出力を好むことが実際に確認されています。また、より強いモデルほど間違い方が似るという研究もあり、別の会社のモデルでも同じです。私たちが読んだAnthropic、OpenAI、Google、Microsoftの公式資料は、別の会社のモデルに替えてレビューするよう求めていません。Anthropicが求めているのは、新しいモデルのインスタンスとクリーンなcontextです。そこで小企鵝は、別の会社のモデルに替えることを安価な保険と考えました。実際に見つかった例が、上の表の4行目です。品質を支えるのは、レビュアーがクリーンなcontextを持ち、元の証拠を直接読み、具体的なチェック基準を手にしていることです。
小企鵝のまとめ
- 作業指示は、新しい同僚への引き継ぎのように書く。 相手は、それまでの会話を知りません。最も重要な前提は、渡す前に自分で一度検証します。
- チェック担当と実行担当を分ける。 プログラミングができなくても応用できます。2つの会話を開き、一方には執筆を任せ、もう一方には元の資料だけを渡して一つずつ間違いを探させます。小企鵝のチームでは、執筆担当は証拠ファイルだけを使い、最後は別の会社のモデルにレビューさせました。
- 1つのAIでうまくできるなら、チームにしない。 マルチエージェントは、範囲が広く、並行して進められ、失敗のコストが高い仕事に限って使います。
- 好み、承認、取り消せない判断は人間に残す。 記事の切り口、カバー画像、公開ボタンは、小企鵝のチームでも小企鵝本人が担当しました。
Anthropicのエンジニアリングチームは、harnessの各部品には、「モデルだけでは何ができないのか」という前提が隠れていると書いています。モデルが強くなったとき、どの部品を外せるのか。小企鵝のチームは、まだ1つずつ試しているところです。
基本的な考え方をさらに知りたい人は、AIエージェント特集から読み始めてください。contextの仕組みについては、AIエージェントの記憶メカニズムも参照できます。
参考資料
カバー画像出典:Anthropic(claude.dev)
公式資料は今後も更新されるため、内容は2026-09-23時点で確認したものです。
- Anthropic(claude.dev):A harness for every task: dynamic workflows in Claude Code,https://claude.dev/blog/a-harness-for-every-task-dynamic-workflows-in-claude-code/
- Anthropic:Building multi-agent systems: when and how to use them,https://claude.com/blog/building-multi-agent-systems-when-and-how-to-use-them
- Anthropic:Harnessing Claude’s intelligence,https://claude.com/blog/harnessing-claudes-intelligence
- Claude Codeドキュメント:Workflows,https://code.claude.com/docs/en/workflows
- Claude Codeドキュメント:Glossary,https://code.claude.com/docs/en/glossary
- Claude Codeドキュメント:Subagents,https://code.claude.com/docs/en/sub-agents
- Claude Codeドキュメント:Agent teams,https://code.claude.com/docs/en/agent-teams
- Claude Codeドキュメント:Best practices,https://code.claude.com/docs/en/best-practices
- Anthropic Engineering:Building effective agents,https://www.anthropic.com/engineering/building-effective-agents
- Anthropic Engineering:How we built our multi-agent research system,https://www.anthropic.com/engineering/multi-agent-research-system
- Anthropic Engineering:Harness design for long-running application development,https://www.anthropic.com/engineering/harness-design-long-running-apps
- OpenAI:A practical guide to building agents,https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
- Google Agent Development Kit:Workflows,https://google.github.io/adk-docs/workflows/
- Microsoft Azure Architecture Center:AI agent orchestration patterns,https://learn.microsoft.com/en-us/azure/architecture/ai-ml/guide/ai-agent-design-patterns
- Microsoft Agent Framework:Overview,https://learn.microsoft.com/en-us/agent-framework/overview/
- Cognition:Multi-Agents: What’s Actually Working(2026),https://cognition.com/blog/multi-agents-working
- Cemri et al.(2025)Why Do Multi-Agent LLM Systems Fail?,https://arxiv.org/abs/2503.13657
- Kim et al.(2025)Towards a Science of Scaling Agent Systems,https://arxiv.org/abs/2512.08296
- Wang et al.(2024)Rethinking the Bounds of LLM Reasoning: Are Multi-Agent Discussions the Key?,https://arxiv.org/abs/2402.18272
- Panickssery et al.(2024)LLM Evaluators Recognize and Favor Their Own Generations,https://arxiv.org/abs/2404.13076
- Wataoka et al.(2024)Self-Preference Bias in LLM-as-a-Judge,https://arxiv.org/abs/2410.21819
- Verga et al.(2024)Replacing Judges with Juries,https://arxiv.org/abs/2404.18796
- Kim et al.(2025)Correlated Errors in Large Language Models,https://arxiv.org/abs/2506.07962